

Explicación: ¿Cómo la regularización L1 selecciona automáticamente las características?
Comprenda el proceso de selección automática de características realizado por la regularización L1 (LASSO).

La selección de características es el proceso de seleccionar un subconjunto óptimo de características de un conjunto dado de características; El subconjunto óptimo es el que maximiza el rendimiento del modelo en la tarea dada.
La selección de características puede ser un proceso manual o, más precisamente, explícito cuando se realiza mediante métodos de filtrado o envoltura . En estos métodos, las características se añaden o eliminan repetidamente en función de un valor métrico fijo, que determina la importancia de la característica para realizar predicciones. Estas métricas pueden ser la ganancia de información, la varianza o la estadística chi-cuadrado, y el algoritmo decidirá si acepta o rechaza una característica en función de un umbral fijo en la métrica. Es importante destacar que estos métodos no forman parte de la fase de entrenamiento del modelo y se realizan previamente.
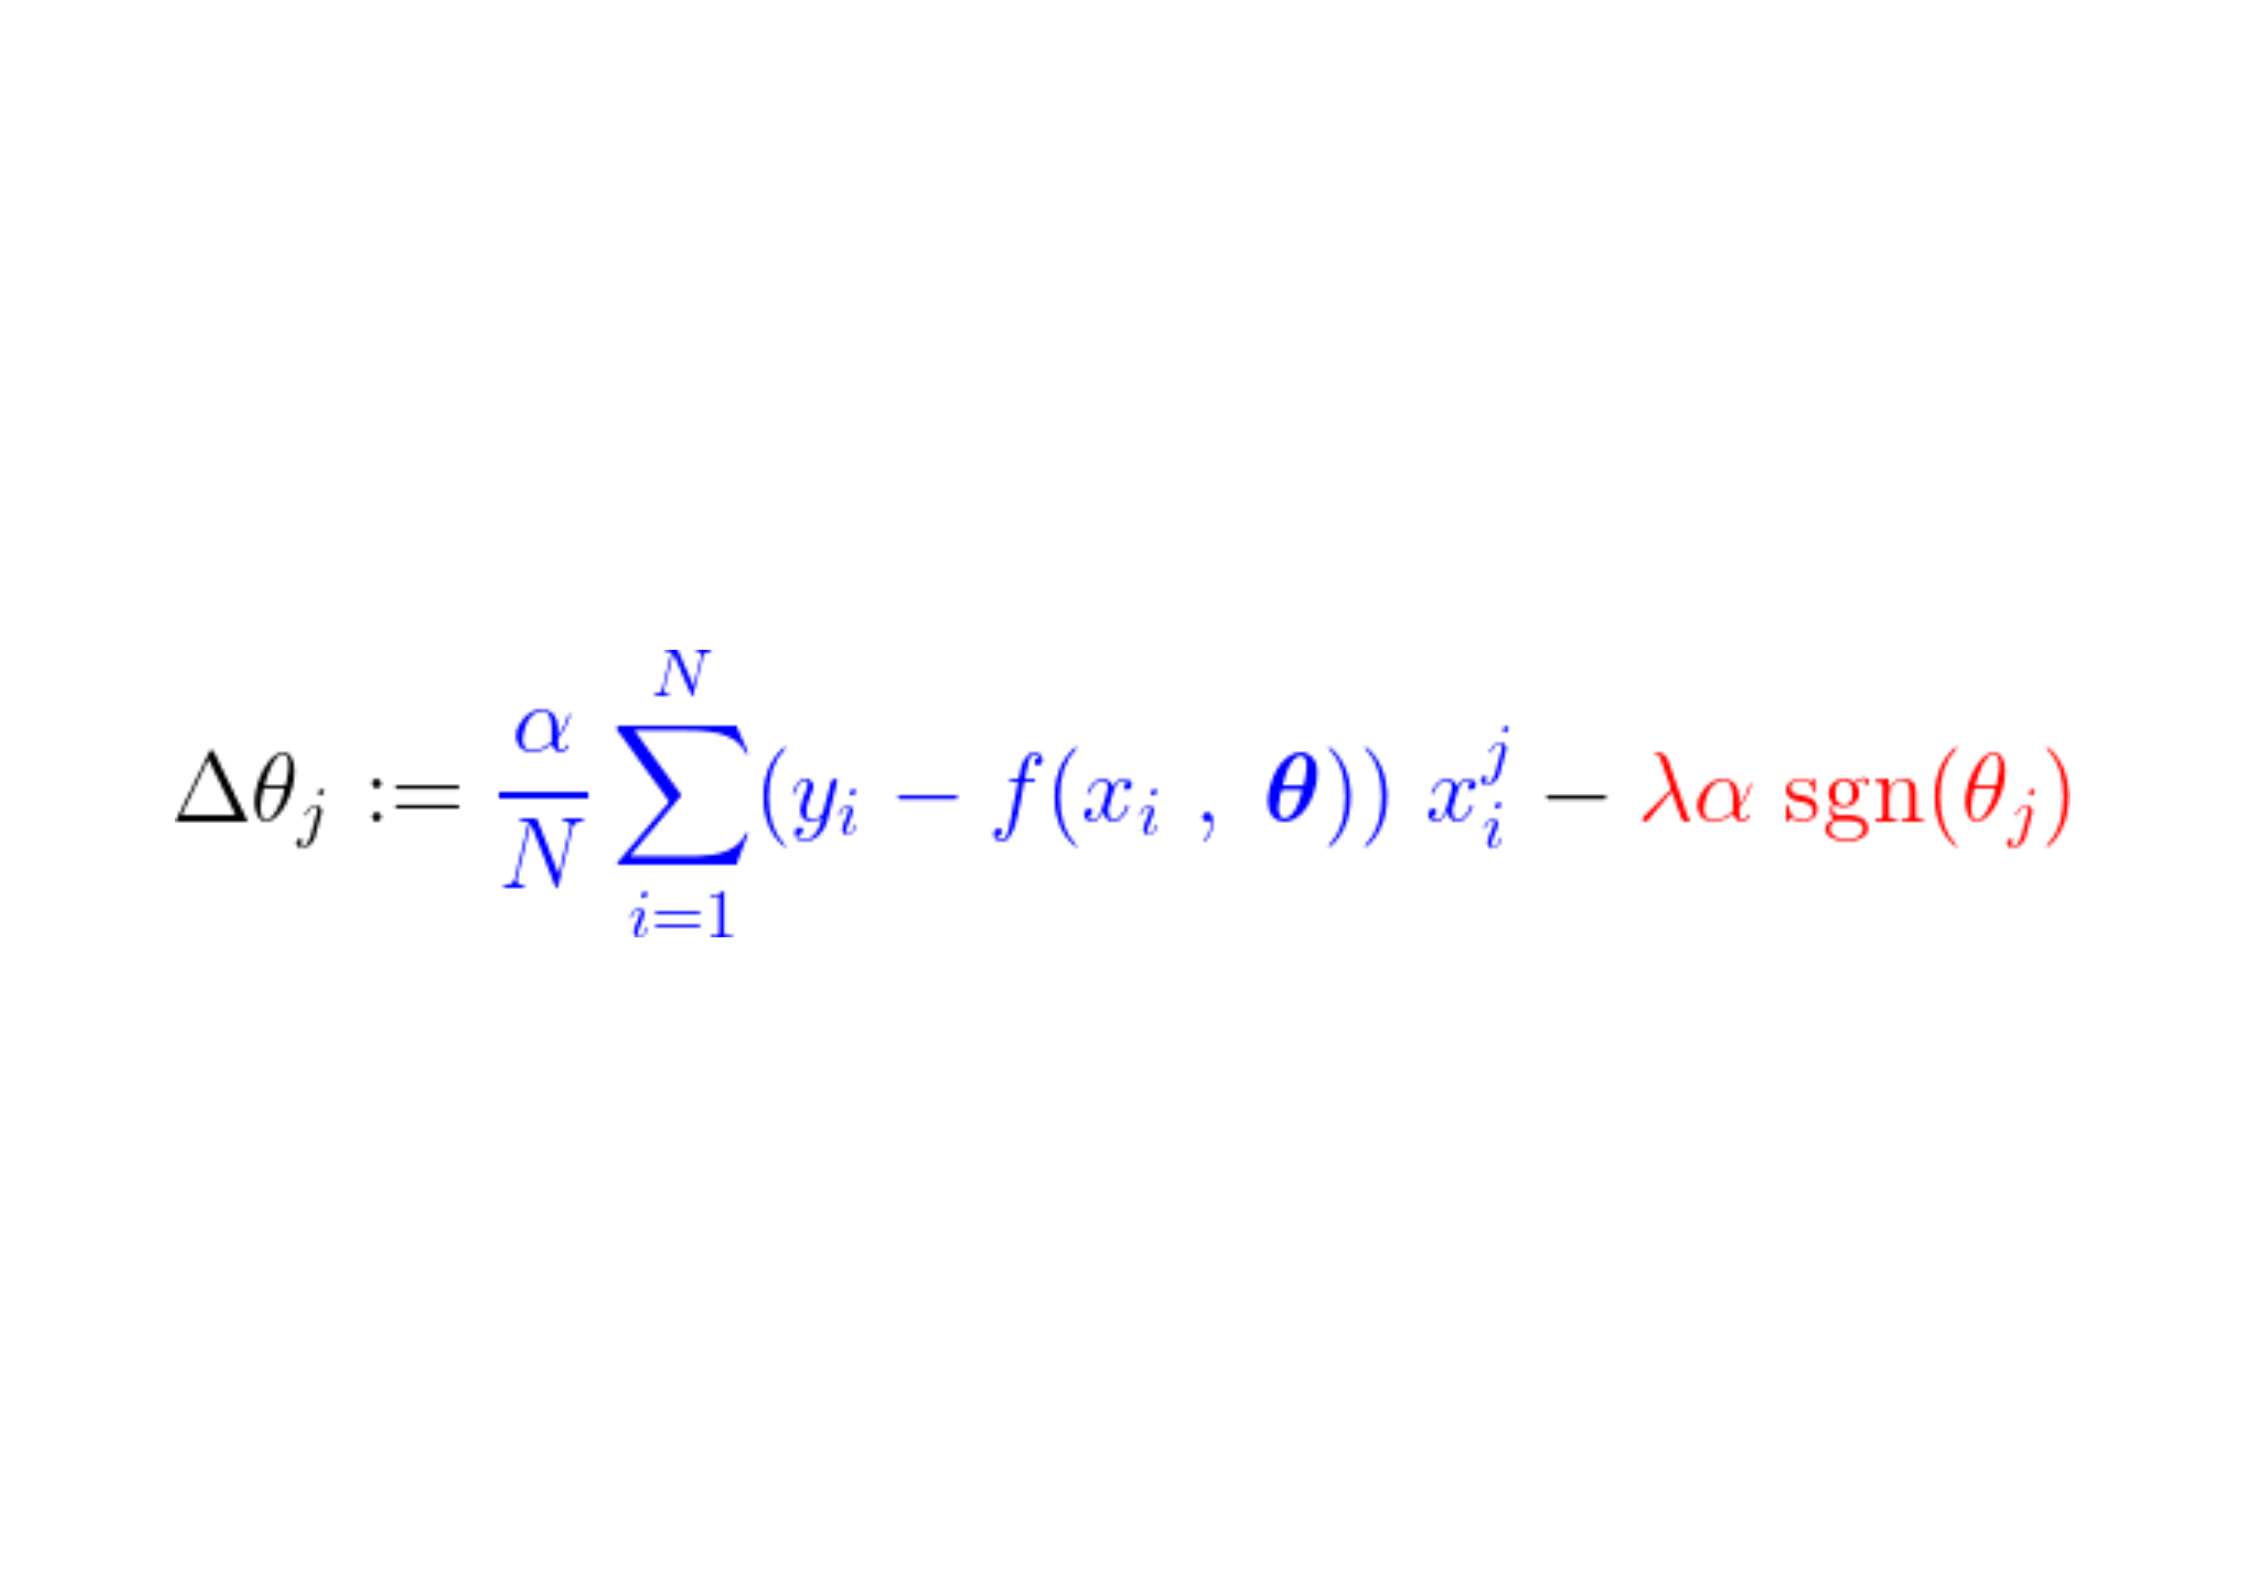
Los métodos integrados identifican implícitamente las características sin utilizar criterios de selección predefinidos y las extraen directamente de los datos de entrenamiento. Este proceso de identificación de características intrínsecas forma parte de la fase de entrenamiento del modelo. El modelo aprende a identificar características y a realizar predicciones relacionadas simultáneamente. En secciones posteriores, describiremos el papel de la regularización en este proceso de identificación de características intrínsecas, centrándonos en la regularización L1 y su función en la mejora de los modelos de aprendizaje automático.
Normalización y complejidad del modelo: estrategias avanzadas para mejorar el rendimiento
La regularización es el proceso de penalizar la complejidad del modelo para evitar el sobreajuste y lograr la generalización a la tarea.
En este caso, la complejidad del modelo es análoga a su capacidad de adaptación a los patrones de los datos de entrenamiento. Suponiendo un modelo polinómico simple en ' x ' con grado ' d ', cuanto mayor sea el grado ' d ' del polinomio, más flexible será el modelo para capturar patrones en los datos observados. Esta mayor flexibilidad puede llevar al modelo a memorizar los datos de entrenamiento en lugar de aprender los patrones reales, reduciendo así su capacidad de generalización a nuevos datos.
Sobreajuste y subajuste
Al intentar ajustar un modelo polinómico de grado d = 2 a un conjunto de muestras de entrenamiento derivadas de un polinomio de tercer grado con cierto ruido, el modelo no logrará capturar adecuadamente la distribución de la muestra. El modelo simplemente carece de la flexibilidad o complejidad necesarias para modelar datos generados por polinomios de tercer grado (o superiores). Se dice que este modelo está subajustado a los datos de entrenamiento. El subajustado indica que el modelo es demasiado simplista y no puede capturar los patrones subyacentes en los datos.
Siguiendo con el mismo ejemplo, supongamos ahora que tenemos un modelo con un grado d = 6. Ahora, con una mayor complejidad, el modelo debería estimar fácilmente el polinomio cúbico original utilizado para generar los datos (por ejemplo, estableciendo los coeficientes de todos los términos con exponentes > 3 a 0). Si el proceso de entrenamiento no se interrumpe a tiempo, el modelo seguirá utilizando su flexibilidad adicional para reducir aún más el error y comenzará a captar también muestras de ruido. Esto reducirá significativamente el error de entrenamiento, pero el modelo ahora sufre de sobrecarga de datos de entrenamiento. El ruido cambiará en entornos reales (o durante las pruebas), y cualquier conocimiento basado en predicciones se verá afectado, lo que resultará en un alto error de prueba. La sobrecarga significa que el modelo es demasiado complejo y está aprendiendo ruido en lugar de la señal real.
¿Cómo determinar la complejidad óptima del modelo?
En entornos prácticos, a menudo tenemos una comprensión limitada o nula del proceso de generación de datos o de la verdadera distribución de los mismos. Encontrar el modelo óptimo con la complejidad apropiada, de modo que no haya sobreajuste ni subajuste, es un desafío importante. Esto requiere el uso de métodos efectivos para evaluar el desempeño de los modelos y determinar la complejidad apropiada que logre el mejor equilibrio entre precisión y generalidad. Al utilizar métricas y técnicas de evaluación adecuadas, como la validación cruzada, los profesionales pueden identificar el modelo que funciona mejor con datos no vistos, evitando así problemas de sobreajuste o subajuste.
Una técnica posible es comenzar con un modelo suficientemente robusto y luego reducir su complejidad mediante la selección de características. Cuanto menos características tenga, menos complejo será el modelo.
Como discutimos en la sección anterior, la selección de características puede ser explícita (métodos de filtrado, métodos de convolución) o implícita. Las características redundantes que no son muy importantes para determinar el valor de la variable objetivo deben eliminarse para evitar que el modelo aprenda patrones no correlacionados en ellas. La regularización también realiza una tarea similar. Entonces, ¿cómo se relacionan la regularización y la selección de características con el logro de un objetivo común de complejidad óptima del modelo? Reducir la complejidad en los modelos de aprendizaje automático es crucial para mejorar el rendimiento y evitar el sobreajuste, que es en lo que se centran tanto la regularización como la selección de características.
La regularización L1 como determinante de características
Continuando con nuestro modelo polinomial, lo representamos como una función de f, con entradas x , coeficientes θ y grado d ,
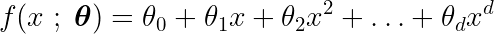
Para el modelo polinomial, cada potencia de la entrada x_i puede considerarse una característica, formando un vector como sigue:
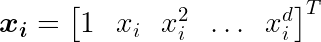
También definimos una función objetivo, cuya reducción conduce a los parámetros ideales θ* e incluye el término regularización , que penaliza la complejidad del modelo.
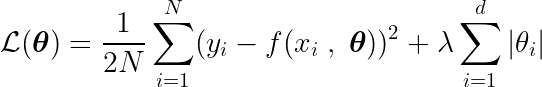
Para encontrar el mínimo de esta función, necesitamos analizar todos los puntos críticos, es decir, los puntos donde la derivada es cero o no está definida.
La derivada parcial con respecto a uno de los parámetros, θj , se puede escribir de la siguiente manera:
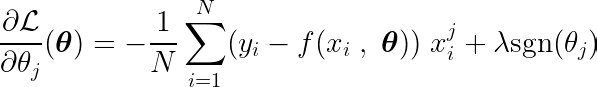
La función sgn se define de la siguiente manera:
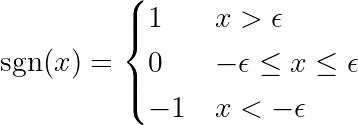
Nota : La derivada de una función absoluta difiere de la función signo (sgn) definida anteriormente. La derivada original no está definida en x = 0. Extendemos la definición para eliminar el punto de inflexión en x = 0 y para que la función sea diferenciable en todo su dominio. Además, los marcos de aprendizaje automático (ML) utilizan estas funciones extendidas cuando las operaciones aritméticas básicas involucran la función absoluta. Consulta este enlace en el foro de PyTorch.
Calculando la derivada parcial de la función objetivo con respecto a un único coeficiente θj y estableciéndola en cero, podemos construir una ecuación que relacione el valor óptimo de θj con las predicciones, los objetivos y las características.
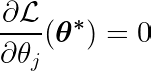
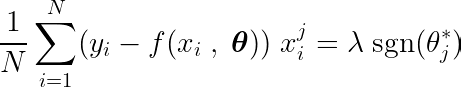
Analicemos la ecuación anterior. Si asumimos que las entradas y los objetivos estaban centrados en torno a la media (es decir, que los datos estaban estandarizados en la etapa de preprocesamiento), entonces el término del lado izquierdo (LHS) representa efectivamente la varianza entre la característica número j y la diferencia entre los valores esperados y los valores objetivo.
La covarianza estadística entre dos variables determina la cantidad de influencia que una variable tiene sobre el valor de la segunda variable (y viceversa).
La función signo del lado derecho obliga a que la varianza del lado izquierdo solo tome tres valores (ya que la función signo devuelve únicamente -1, 0 y 1). Si la característica j es innecesaria y no afecta a las predicciones, la varianza será cercana a cero, lo que hace que el coeficiente correspondiente θj* sea cero. Esto provoca que la característica se elimine del modelo. Este proceso ayuda a reducir la complejidad y a mejorar el rendimiento del modelo.
Imagine la función del cartel como un surco tallado por el agua. Se puede caminar dentro del barranco (es decir, el lecho del río), pero para salir de él, se encontrará con enormes barreras o rápidos pronunciados. La regularización L1 crea un efecto de “umbral” similar al gradiente de la función de pérdida. El gradiente debe ser lo suficientemente fuerte como para romper las barreras o convertirse en cero, haciendo eventualmente que el valor del coeficiente sea cero.
Para proporcionar un ejemplo más realista, considere un conjunto de datos que contiene muestras derivadas de una línea recta (parametrizada con dos factores) con algo de ruido agregado. El modelo óptimo no debe tener más de dos parámetros; de lo contrario, se ajustará al ruido de los datos (con la libertad/potencia adicionales del polinomio). Cambiar los coeficientes de potencia más altos en un modelo polinomial no afecta la diferencia entre los objetivos y las predicciones del modelo y, por lo tanto, reduce su variación con la característica.
Durante el proceso de entrenamiento, se agrega/resta un paso fijo al gradiente de la función de pérdida. Si el gradiente de la función de pérdida (MSE – error cuadrático medio) es menor que el paso constante, el coeficiente eventualmente alcanzará un valor de 0. Observe la ecuación a continuación, que muestra cómo se actualizan los coeficientes mediante el descenso de gradiente:

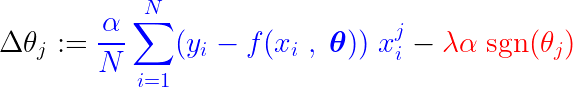
Si la parte azul de arriba es menor que λα , que a su vez es un número muy pequeño, entonces Δθj es aproximadamente un paso constante de λα . El signo de este paso (la parte roja) depende de sgn(θj) , cuyo resultado depende de θj . Si el valor de θj es positivo, es decir, mayor que ε , entonces sgn(θj) es igual a 1, lo que hace que Δθj sea aproximadamente igual a -λα , acercándolo a cero.
Para suprimir el paso constante (parte roja) que hace que el coeficiente sea cero, el gradiente de la función de pérdida (parte azul) debe ser mayor que el tamaño del paso. Para obtener un gradiente mayor para la función de pérdida, el valor de la característica debe afectar significativamente la salida del modelo.
Así es como la característica, o más precisamente, su parámetro correspondiente, cuyo valor no está relacionado con la salida del modelo, se pone a cero mediante la regularización L1 durante el entrenamiento.
Lecturas adicionales y conclusión
- Para obtener más información sobre este tema, publiqué una pregunta en Reddit r/MachineLearning yHacer un seguimiento Contiene diferentes interpretaciones que quizá quieras leer.
- Madiyar Aitbayev también tiene blog interesante Cubre la misma pregunta, pero con una explicación de ingeniería.
- مدونة Brian King explica la organización desde una perspectiva probabilística.
- هذا النقاش En el sitio web CrossValidated explica por qué el criterio L1 fomenta los modelos dispersos. مدونة Un artículo detallado de Mukul Ranjan explica por qué la norma L1 fomenta que las transacciones sean cero y la norma L2 no.
La afirmación de que "la regularización L1 selecciona características" es sencilla y suele coincidir con la mayoría de los expertos en aprendizaje automático, sin profundizar en su funcionamiento interno. Este blog pretende compartir mi comprensión y modelo mental con los lectores para responder a esta pregunta de forma intuitiva. Para sugerencias y preguntas, pueden encontrar mi correo electrónico en mi sitio web . ¡Sigan aprendiendo y que tengan un buen día!

Los comentarios están cerrados.