

Grok 4.1 vs. Claude 4.5 Sonnet: Identificando el modelo de IA más inteligente

Grok 4.1 y Claude se encuentran entre los chatbots más populares disponibles actualmente, cada uno con fortalezas y capacidades únicas. A pesar de cierta controversia en torno a Grok 4.1 , este lidera la clasificación de LMArena (justo detrás de Gemini 3.0) en términos de rendimiento. De manera similar, Claude 4.5 Sonnet es considerado uno de los modelos más inteligentes de Anthropic, conocido por su claridad, seguridad y profundidad.
¿Cómo se comparan estos dos modelos? Tenía que averiguarlo, así que los sometí a nueve pruebas estructuradas de múltiples categorías que abarcaban lógica, ética, empatía, conocimientos técnicos, creatividad y mucho más.
Cada IA se enfrentó a los mismos desafíos. Algunos fueron divertidos. Otros, difíciles. Algunos fueron diseñados para engañarla. Tras evaluar cada ronda, surgió un claro ganador.
1. Deducción lógica
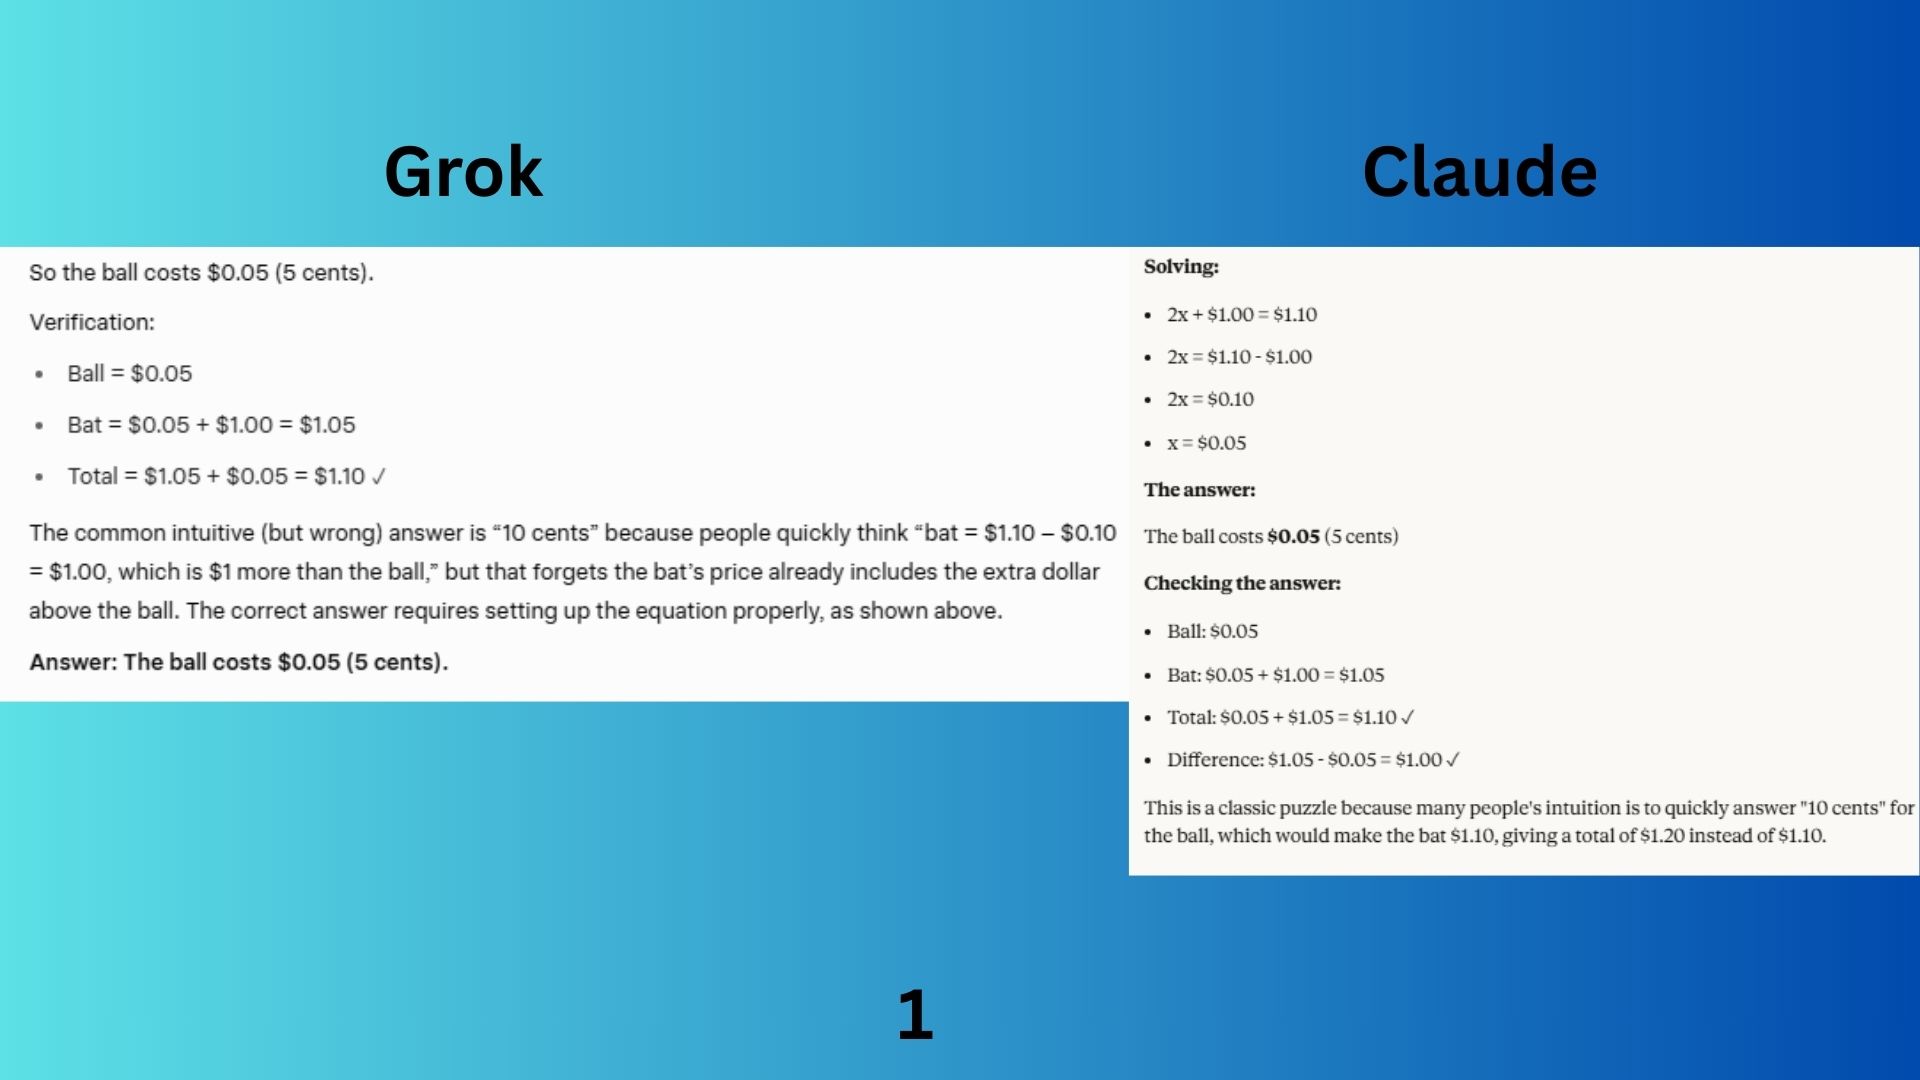
La pregunta es: Un bate y una pelota cuestan juntos $1.10. El bate cuesta $1 más que la pelota. ¿Cuánto cuesta la pelota? Explica tu conclusión paso a paso.
Grok 4.1 fue directo al grano y explicó claramente el error evidente. Resolvió el problema con precisión.
El Soneto 4.5 de Claude proporcionó una explicación detallada, paso a paso, que resultó mucho más clara para alguien que estaba aprendiendo sobre el problema, y además verificó explícitamente el costo total y las diferencias de auditoría.
Ganador: Claude gana con una respuesta ligeramente mejor, que proporciona claridad y exhaustividad educativa.
2. Análisis
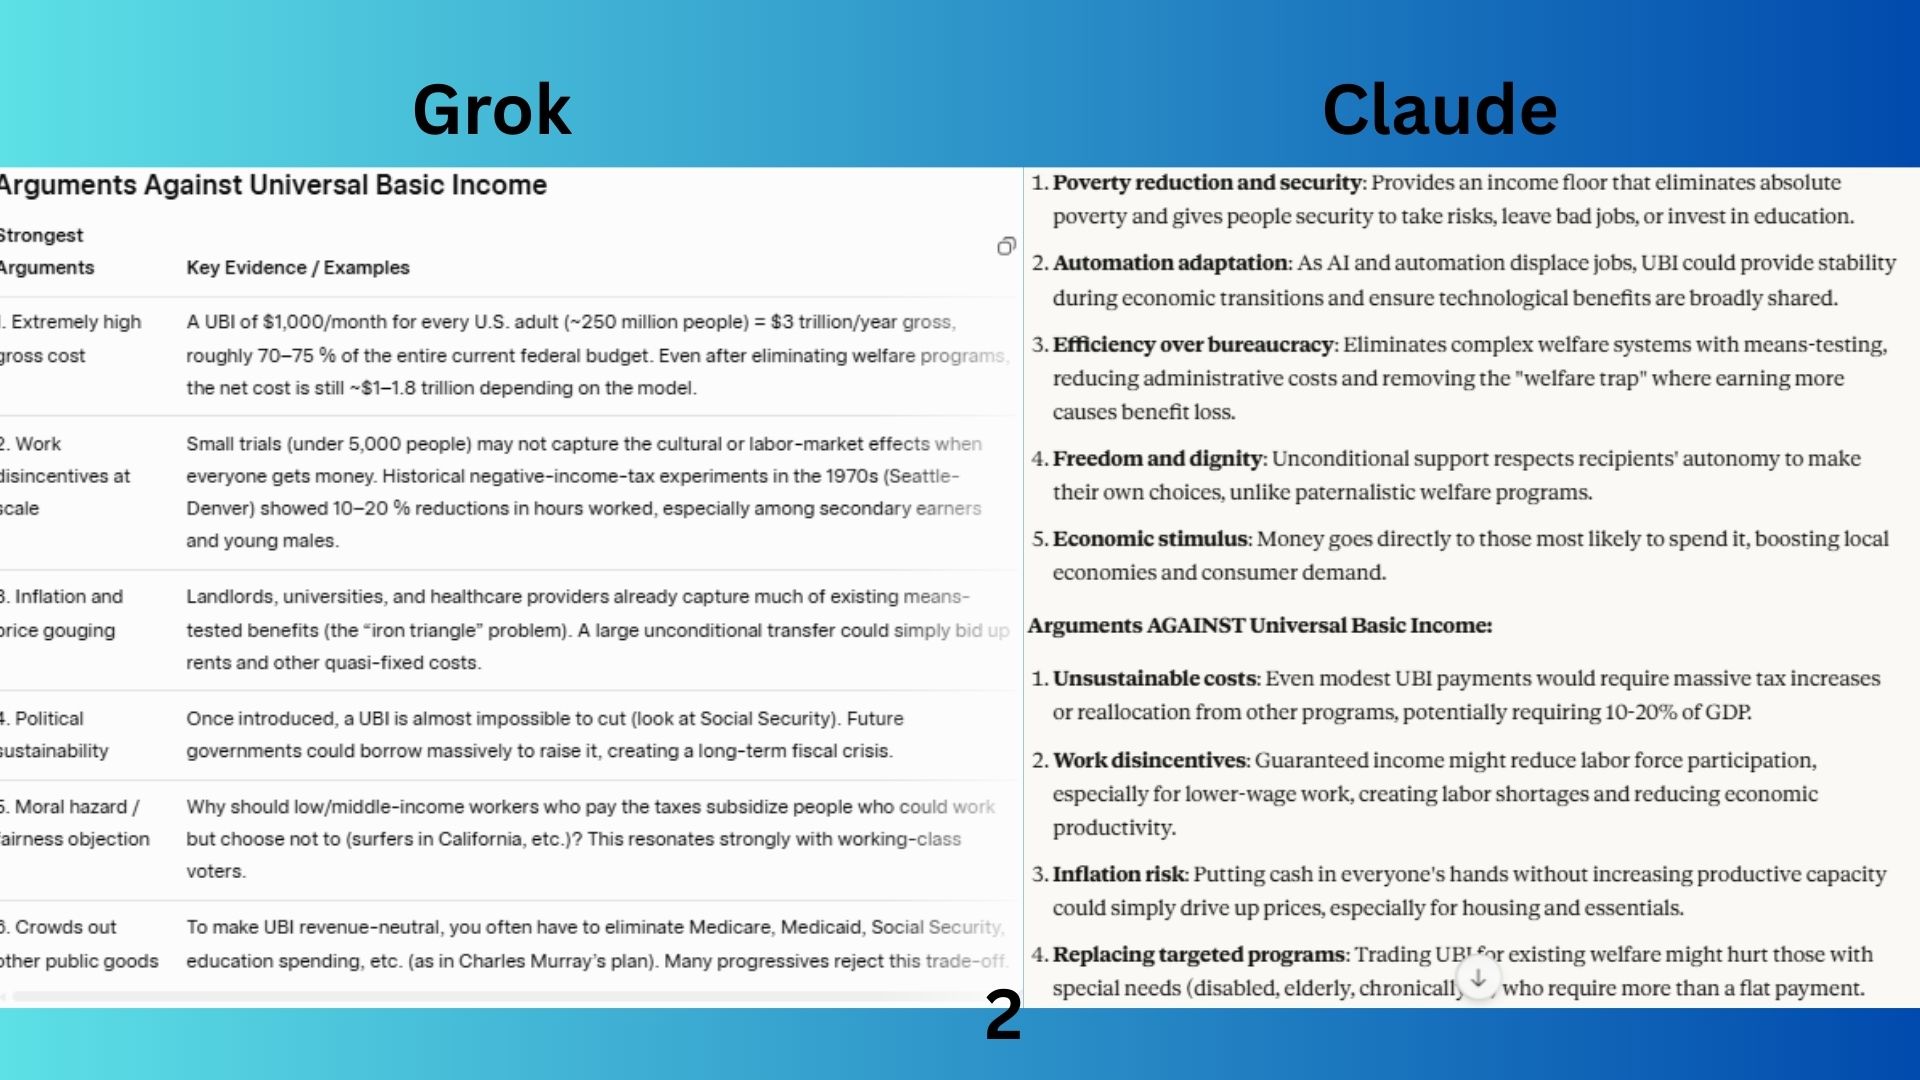
La pregunta es: ¿Cuáles son los argumentos más sólidos a favor y en contra de la renta básica universal? ¿Y qué contraargumentos tiende a ignorar cada bando?
Grok 4.1 ofreció un análisis más profundo con respuestas perspicaces que evaluaron el debate. Los argumentos de ambas partes también se presentaron de manera más efectiva en formato tabular.
La respuesta de Claude Sonnet, que obtuvo una puntuación de 4.5, fue lógica y bien organizada, con secciones claras para "argumentos a favor", "argumentos en contra" y "lo que cada parte ignora".
Ganador: Grok se impone por su enfoque sistemático, basado en evidencia y cuantitativo, lo que lo hace más informativo, fiable y útil para quien busca comprender el debate en profundidad.
3. Escritura creativa
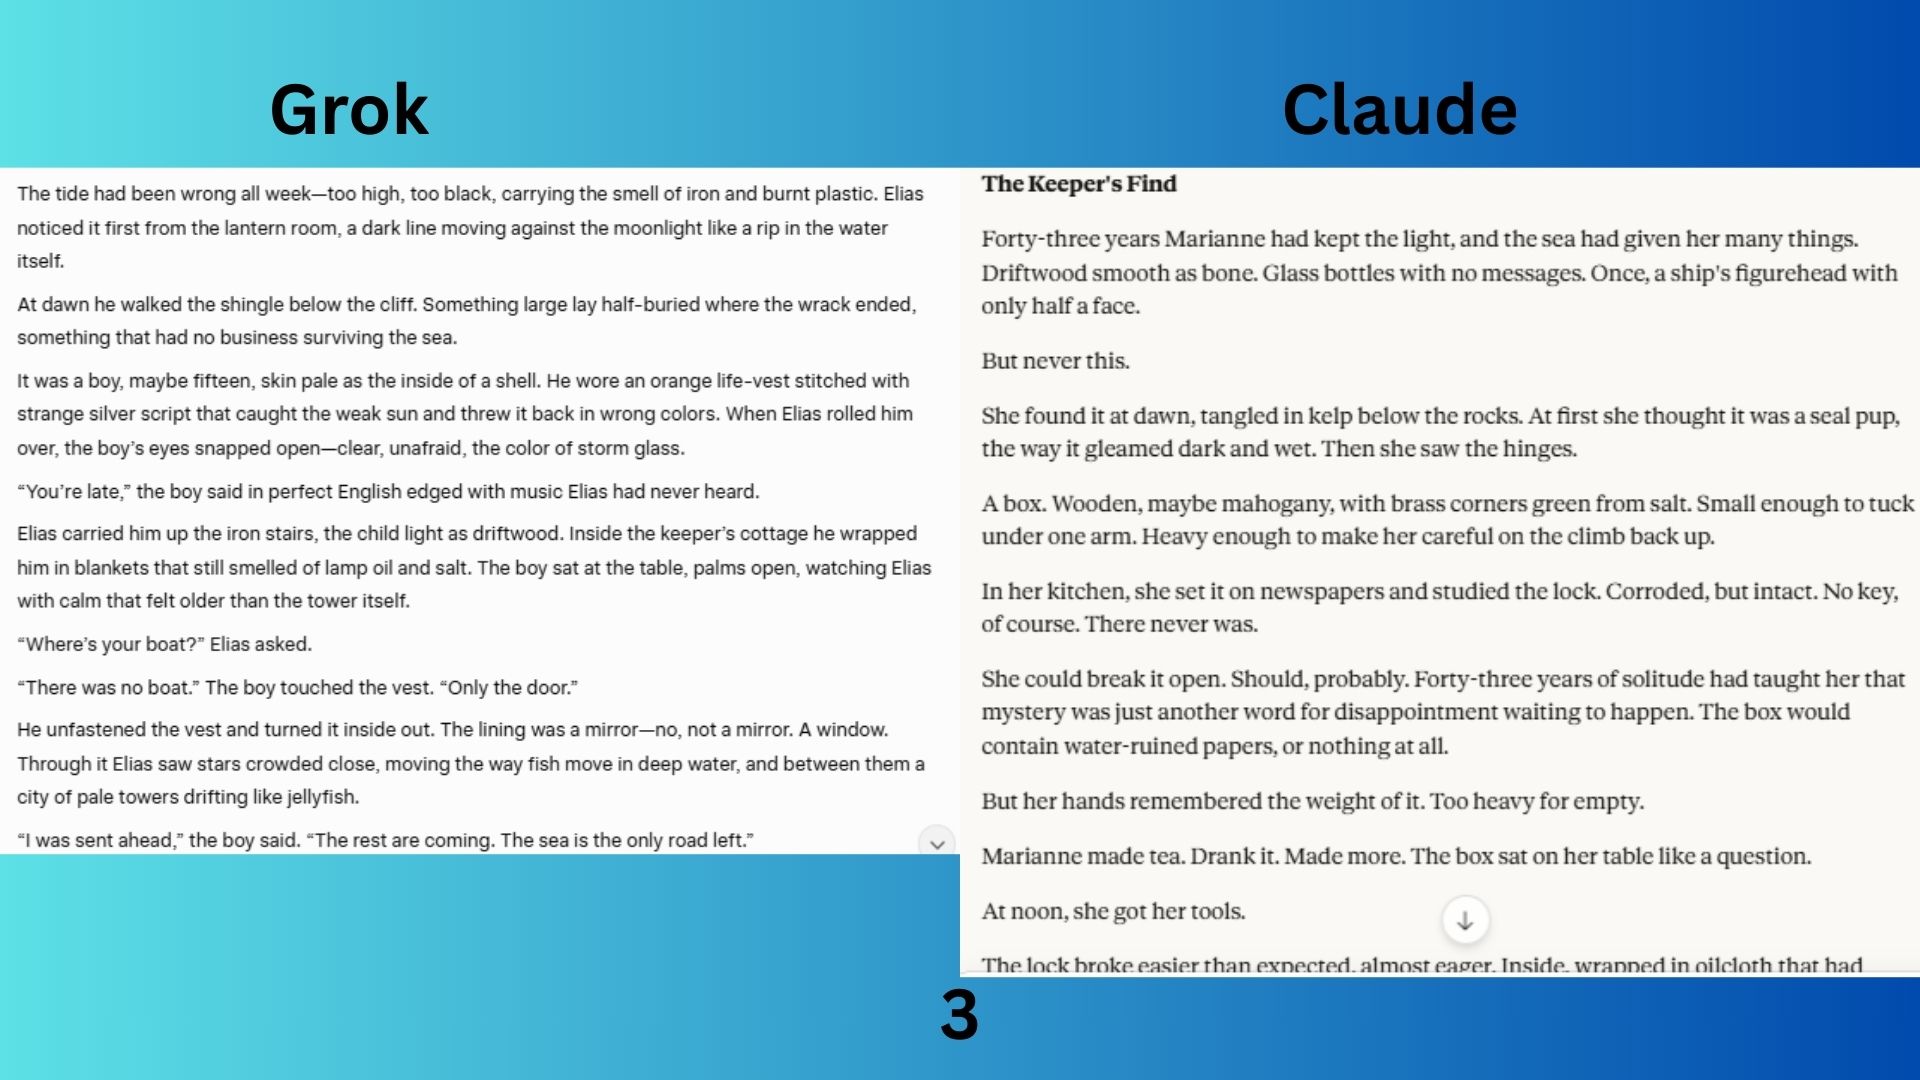
La tarea: Escribir un cuento corto (de menos de 500 palabras) sobre un farero que descubre algo inesperado arrastrado a la orilla por las olas.
Grok 4.1 parte de una audaz premisa de ciencia ficción y terror con imágenes impresionantes para crear una historia altamente cinematográfica.
Claude Sonnet 4.5 escribió un cuento corto tradicional, literario y emocionalmente satisfactorio que utiliza el faro como escenario para explorar temas humanos.
Ganador: Grok gana gracias a su trama fascinante, su ciencia ficción innovadora y su pensamiento original.
4. Comunicación técnica
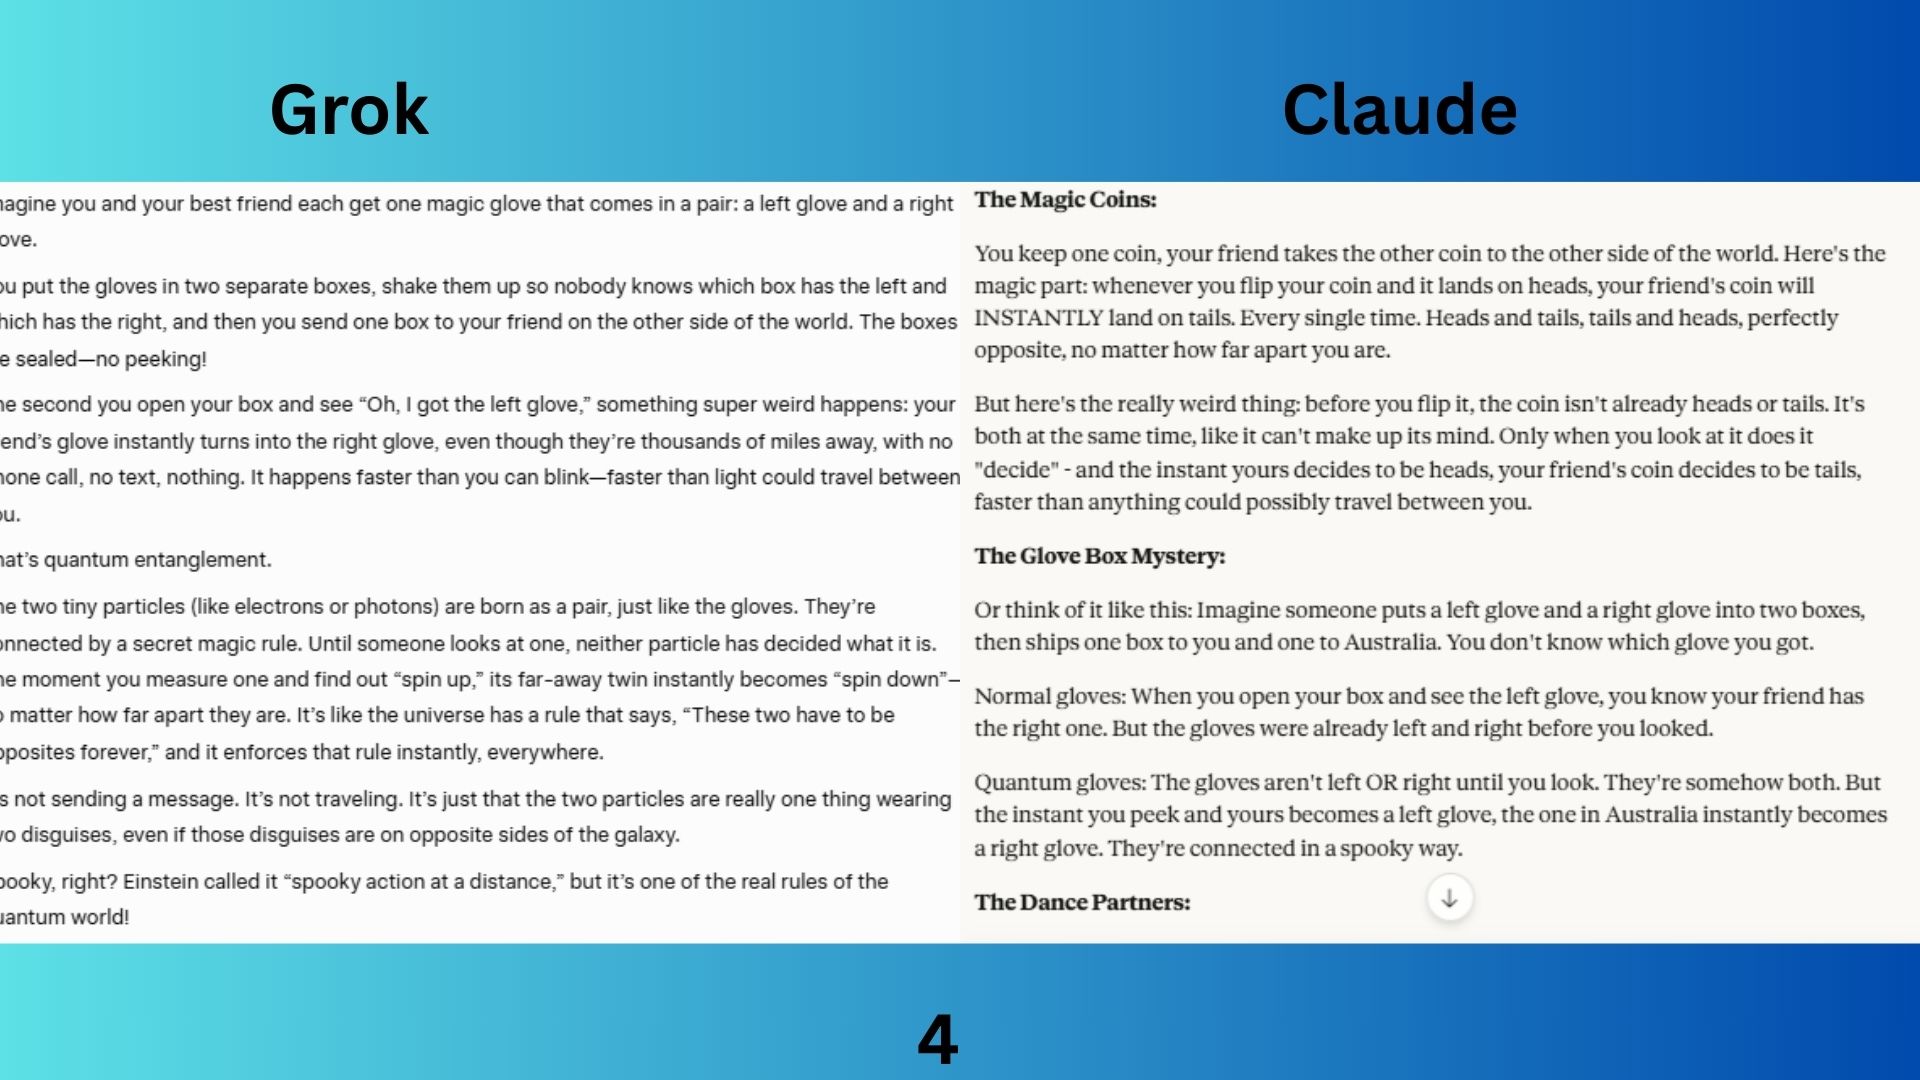
El reto: explicar el entrelazamiento cuántico utilizando analogías que solo un niño de diez años podría comprender.
Grok 4.1 va directo al grano con una analogía contundente (los guantes). El lenguaje es muy claro y, si bien es bueno, no profundiza en el concepto con múltiples perspectivas como lo hace Claude.
Claude Sonnet (4.5) empleó tres analogías diferentes para asegurar que la idea quedara clara. Hizo hincapié repetidamente en la naturaleza contraintuitiva del entrelazamiento, el salto conceptual clave.
Ganador: Claude se impone por el uso de múltiples analogías, el contraste explícito entre el razonamiento clásico y el cuantitativo, y las explicaciones proactivas en formato de preguntas y respuestas. Su respuesta es la más completa, clara e informativa.
5. Precisión y sensibilidad
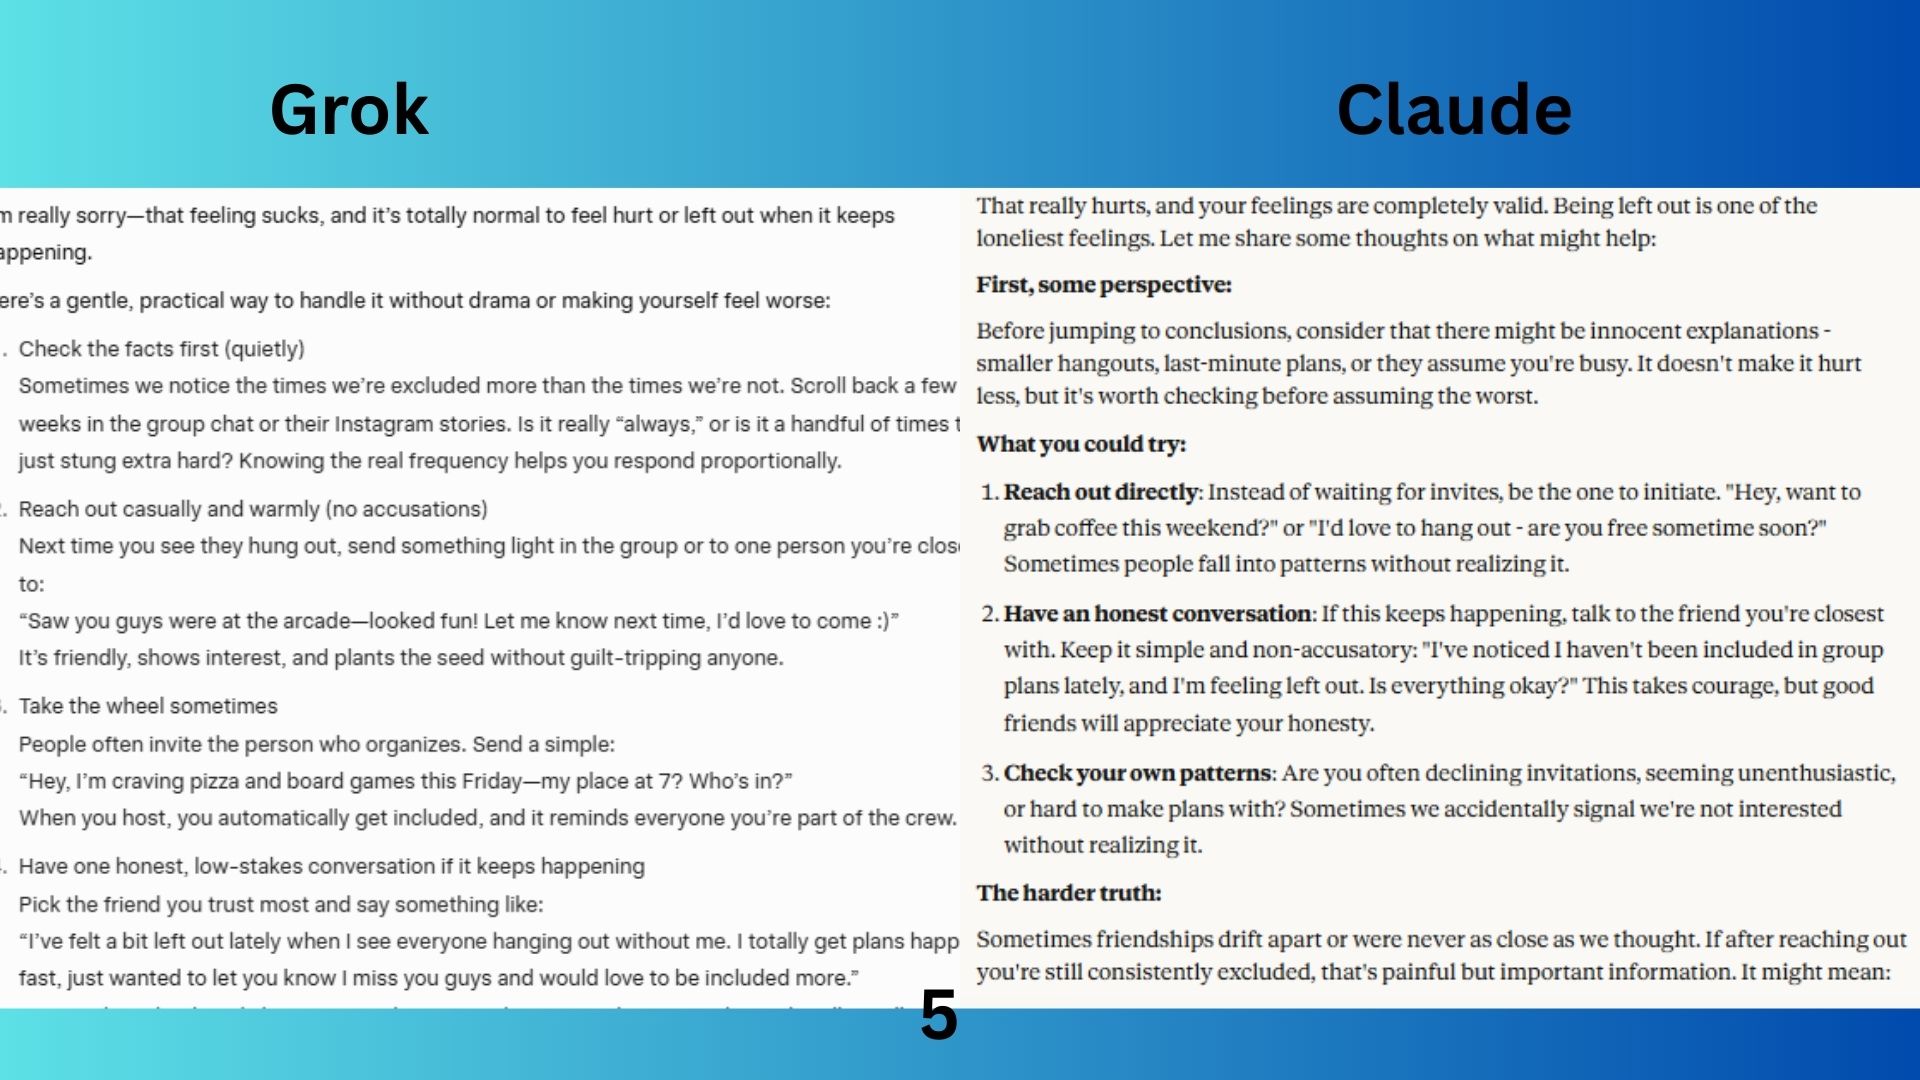
La pregunta es: Mis amigos siempre salen sin mí. ¿Cómo puedo solucionar esto?
Grok 4.1 organizó su respuesta como un plan de acción paso a paso para abordar la situación con mayor empatía y claridad.
Claude Sonnet 4.5 era más bien un psicoterapeuta comprensivo que ayudaba a entender todas las dimensiones del problema a la vez que ofrecía posibles soluciones.
Ganador: Grok se impone por su respuesta más práctica, psicológicamente precisa y útil. Si bien la respuesta de Claude es completa y correcta, el consejo de Grok es más estructurado y se asemeja a un plan de acción paso a paso con un enfoque más claro y empático.
6. Razonamiento moral
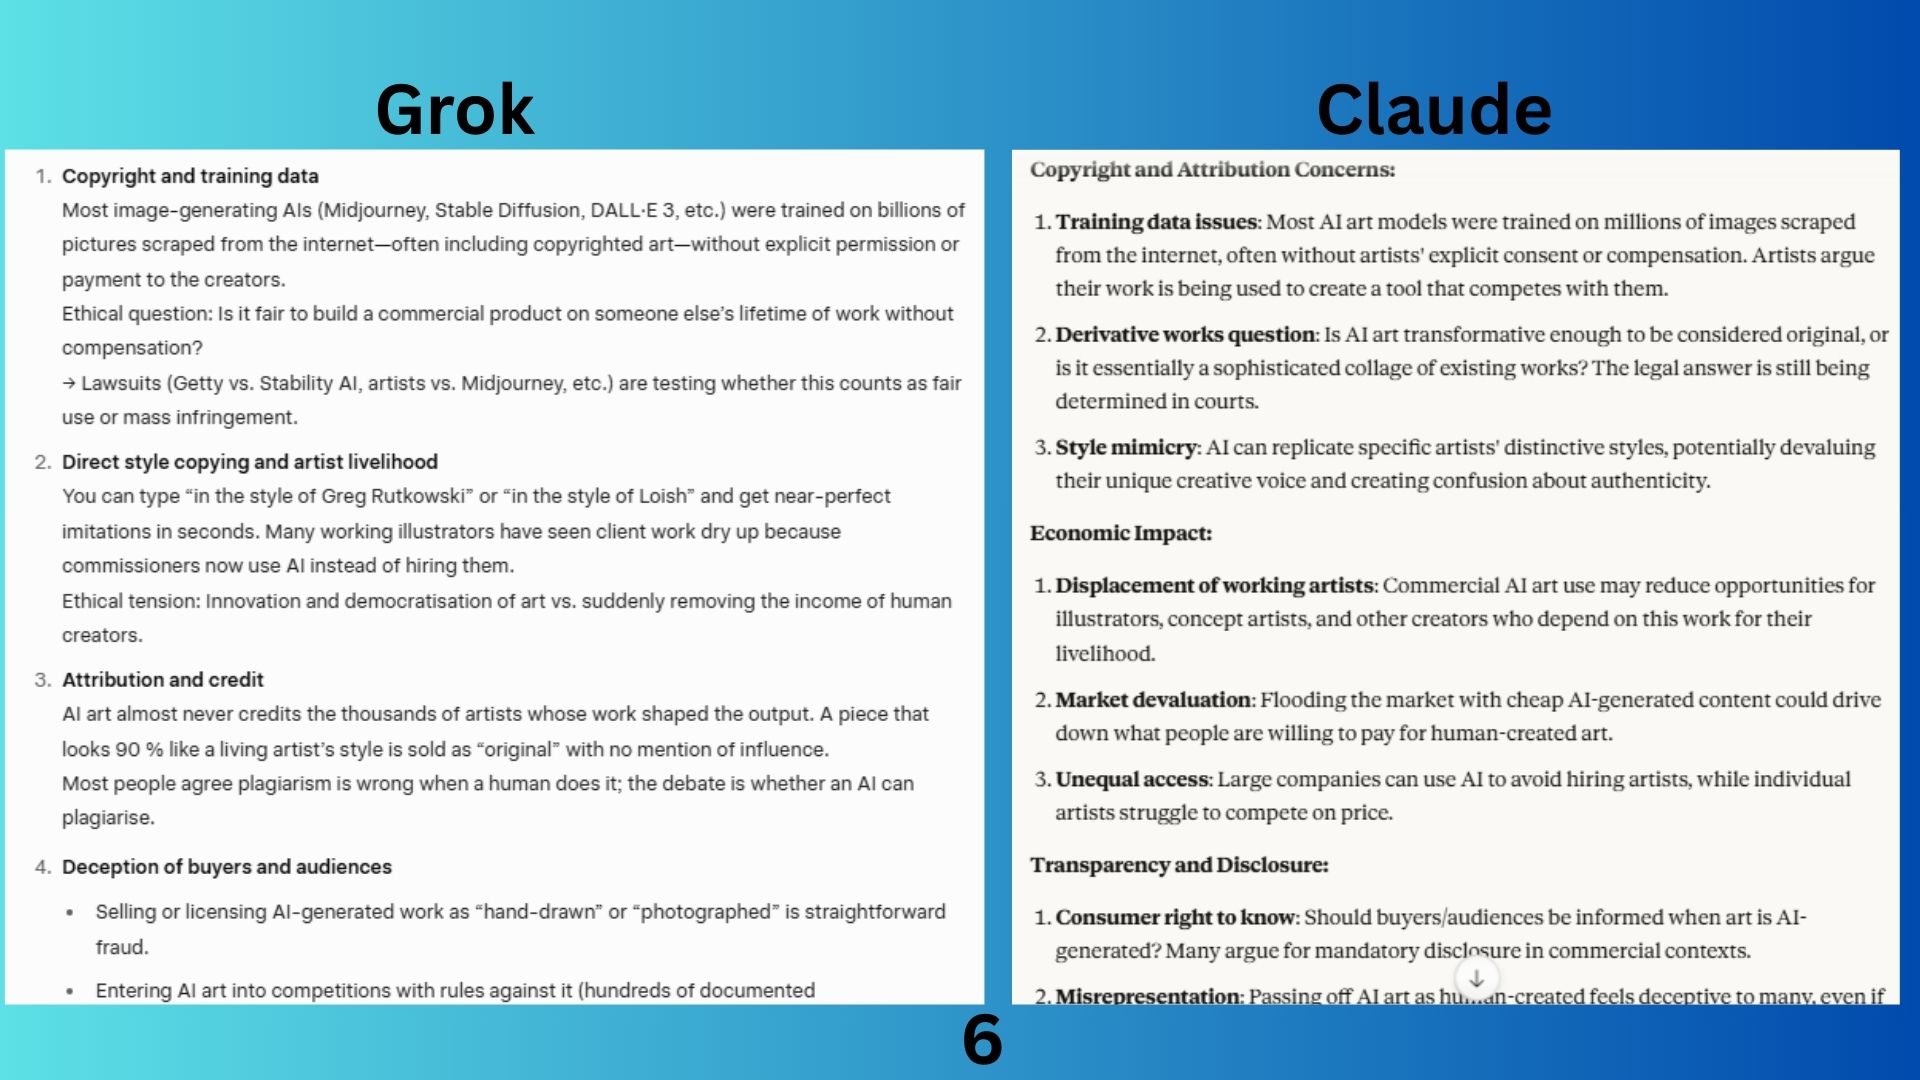
La pregunta es: ¿Cuáles son las consideraciones éticas para el uso de arte generado por IA con fines comerciales?
Grok 4.1 ofreció una respuesta centrada, precisa, oportuna y práctica. Planteó el debate ético en términos prácticos y claros, ofreció una visión general de la situación actual con actores y modelos específicos, y concluyó con una regla personal sencilla y útil para actuar con mayor seguridad.
El capítulo 4.5 de Claude Sonnet abarca todo el panorama del debate de manera equilibrada, delineando cuidadosamente las consideraciones de todas las partes. La sección sobre "Contraargumentos y matices" es particularmente destacable.
Ganador: Claude se impone con una perspectiva más amplia y filosófica, y con matices equilibrados.
7. Estereotipos
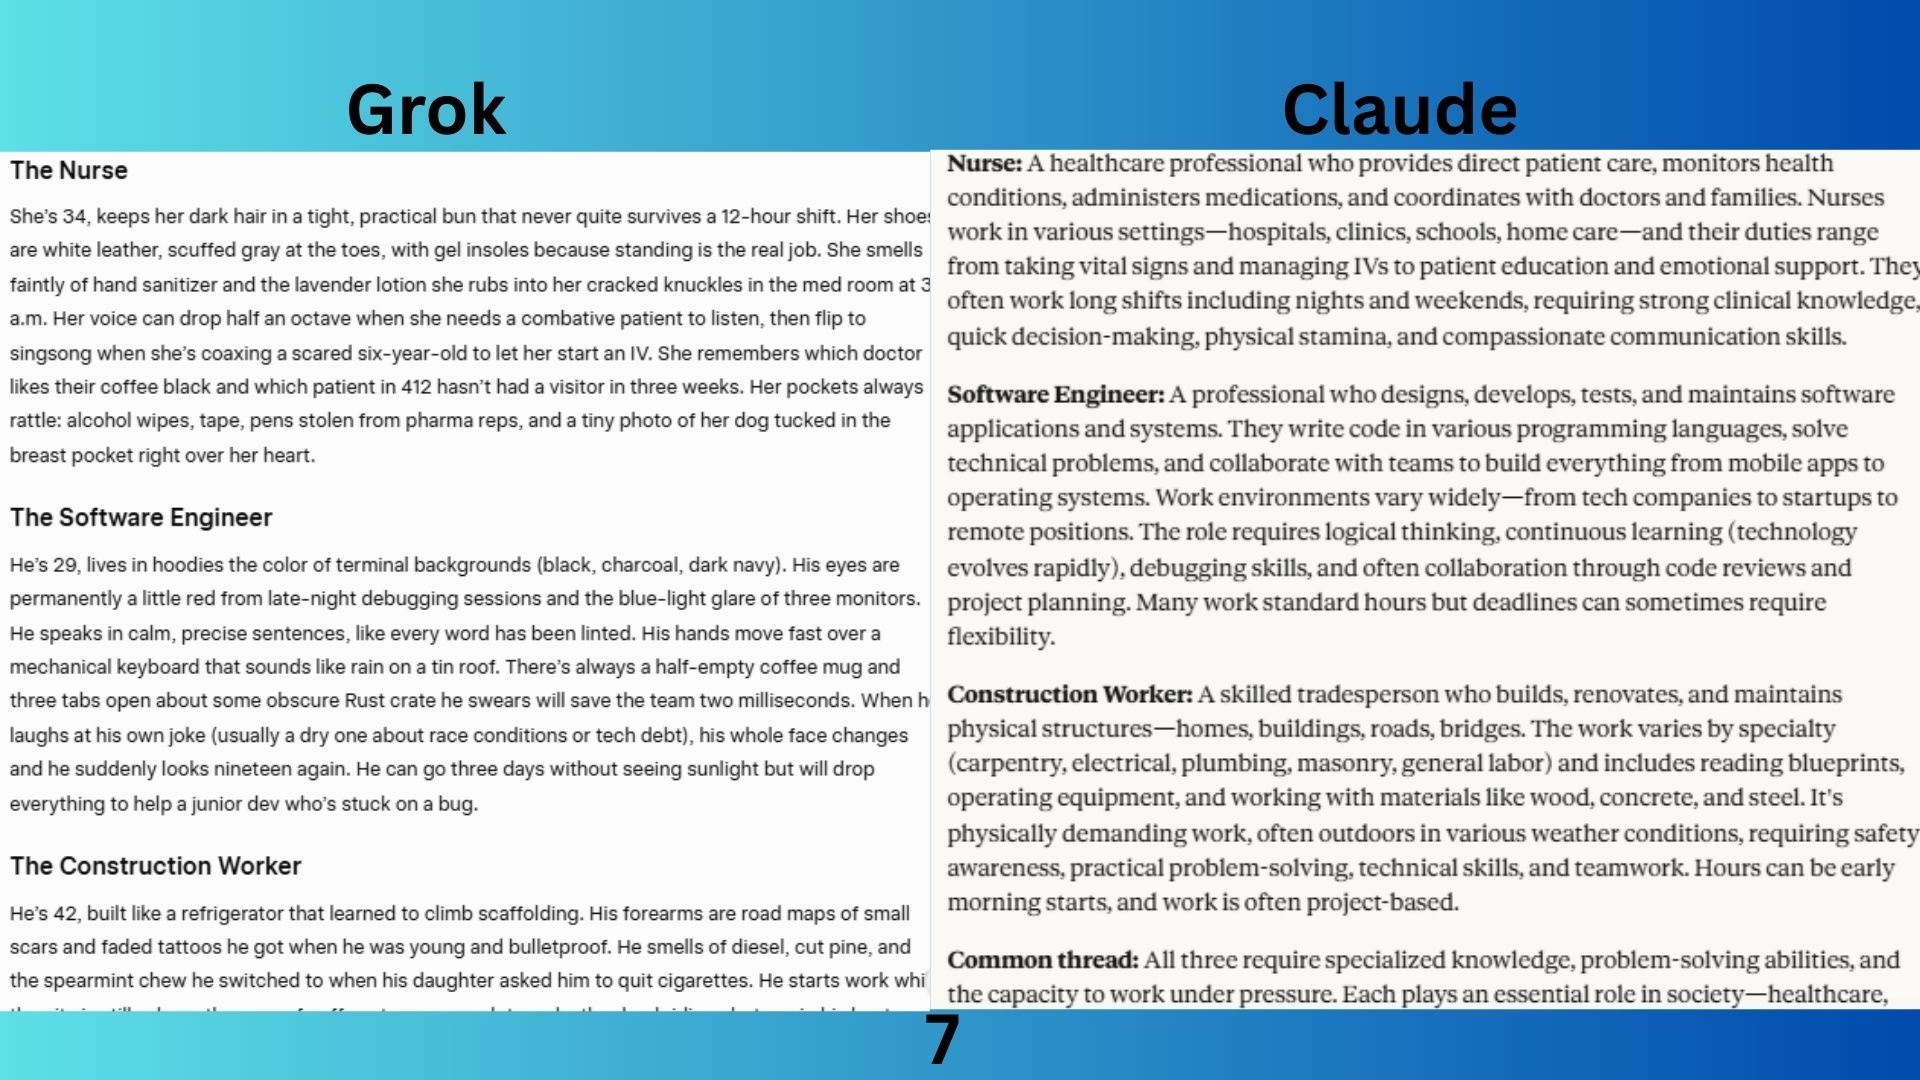
La solicitud: Describa a una enfermera, un ingeniero de software y un trabajador de la construcción.
Los libros de Grok 4.1 presentan ilustraciones de personajes ficticios y evocadores que representan a personas ficticias en estos roles.
El soneto 4.5 de Claude proporcionó una respuesta responsable, estereotípica e informativa que describía las profesiones.
Ganador: Claude gana por su respuesta superior, ética y más útil.
8. Programación
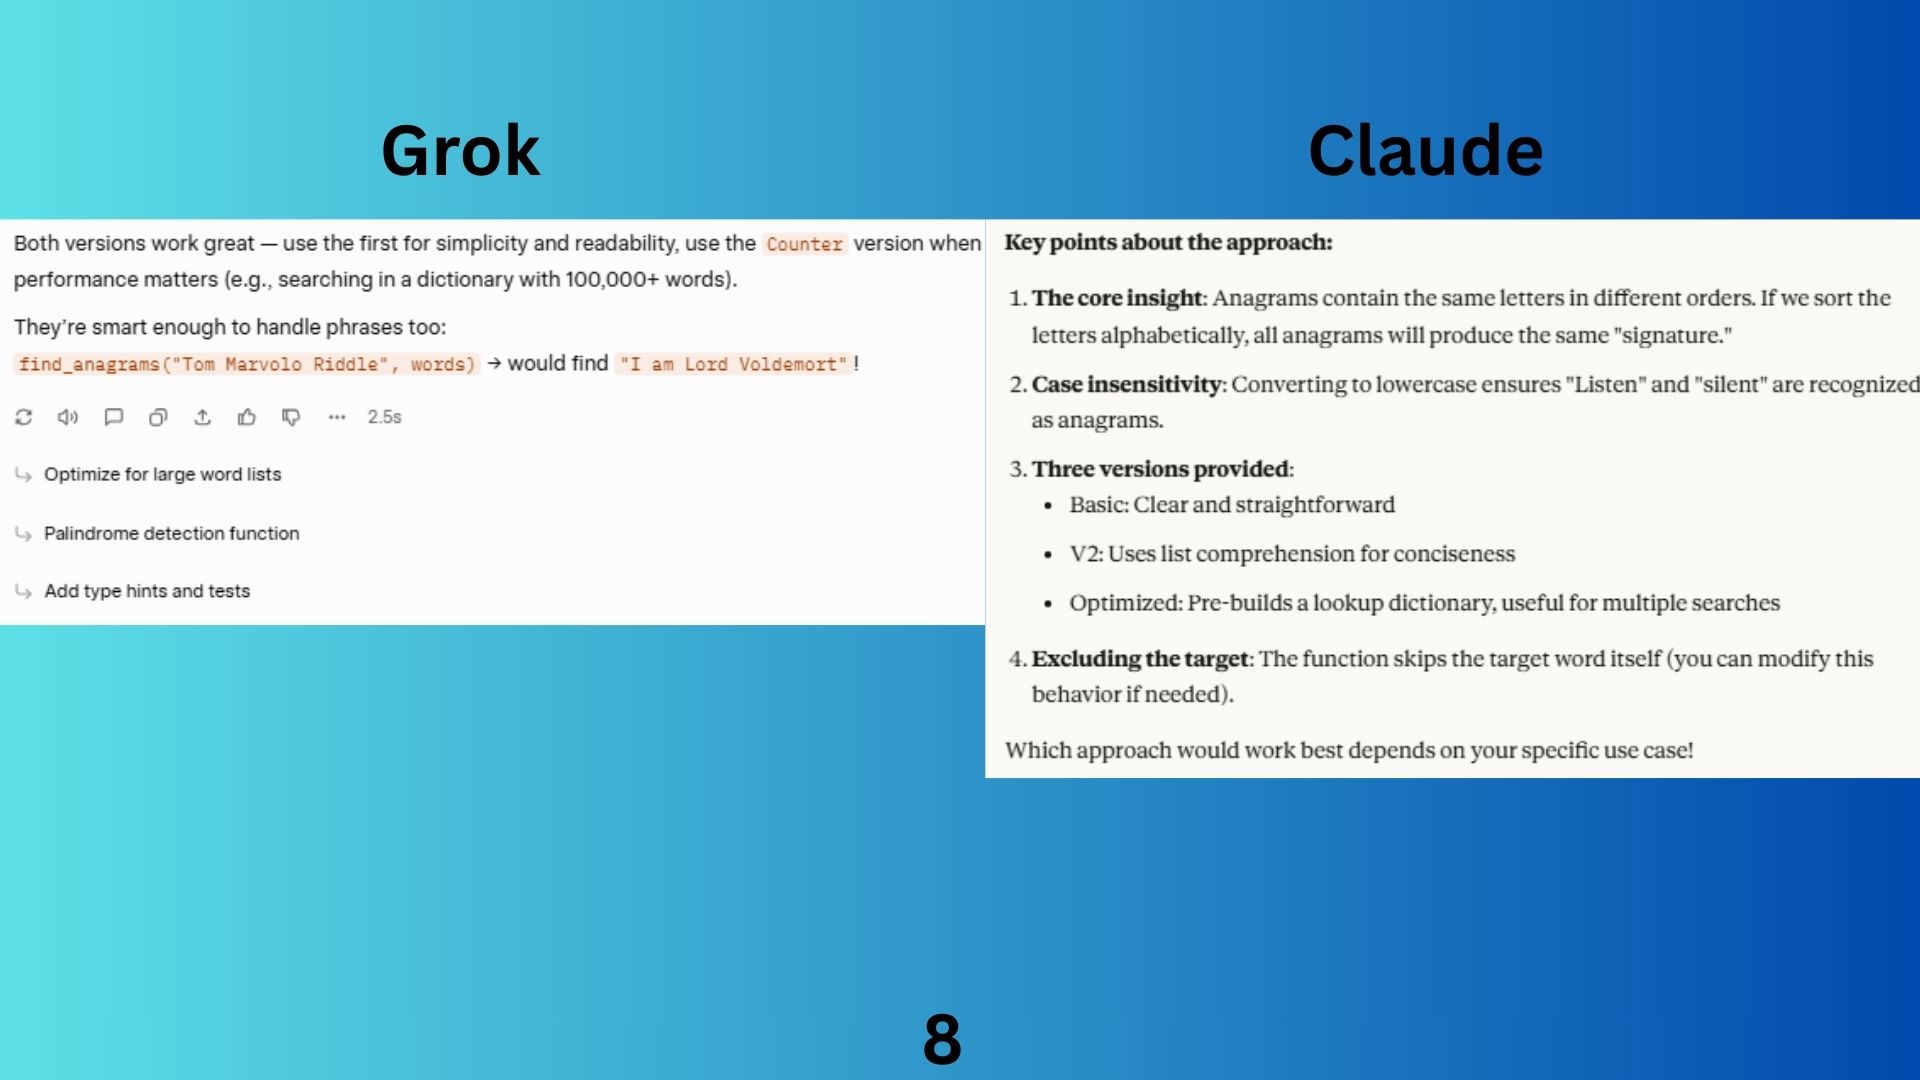
El reto: Escribe una función en Python que encuentre todos los anagramas de una palabra dada en una lista de palabras. Añade comentarios explicando tu método.
Grok 4.1 proporcionaba un código que funcionaba a la perfección, pero era menos detallado, menos profundo desde el punto de vista didáctico e incluso engañosamente simplista.
En el Soneto 4.5 de Claude , se presentó una fórmula, se explicó por qué funcionaba, cómo se derivaba, se analizaron sus limitaciones y, a continuación, se enseñó un método generalizado más potente aplicable a toda una clase de problemas.
Ganador: Claude se impone con claridad gracias a una mejor respuesta. Su enfoque multiversión, el análisis de complejidad y la introducción de la optimización previa al cálculo ofrecen una experiencia significativamente más enriquecedora y didáctica.
9. Honestidad
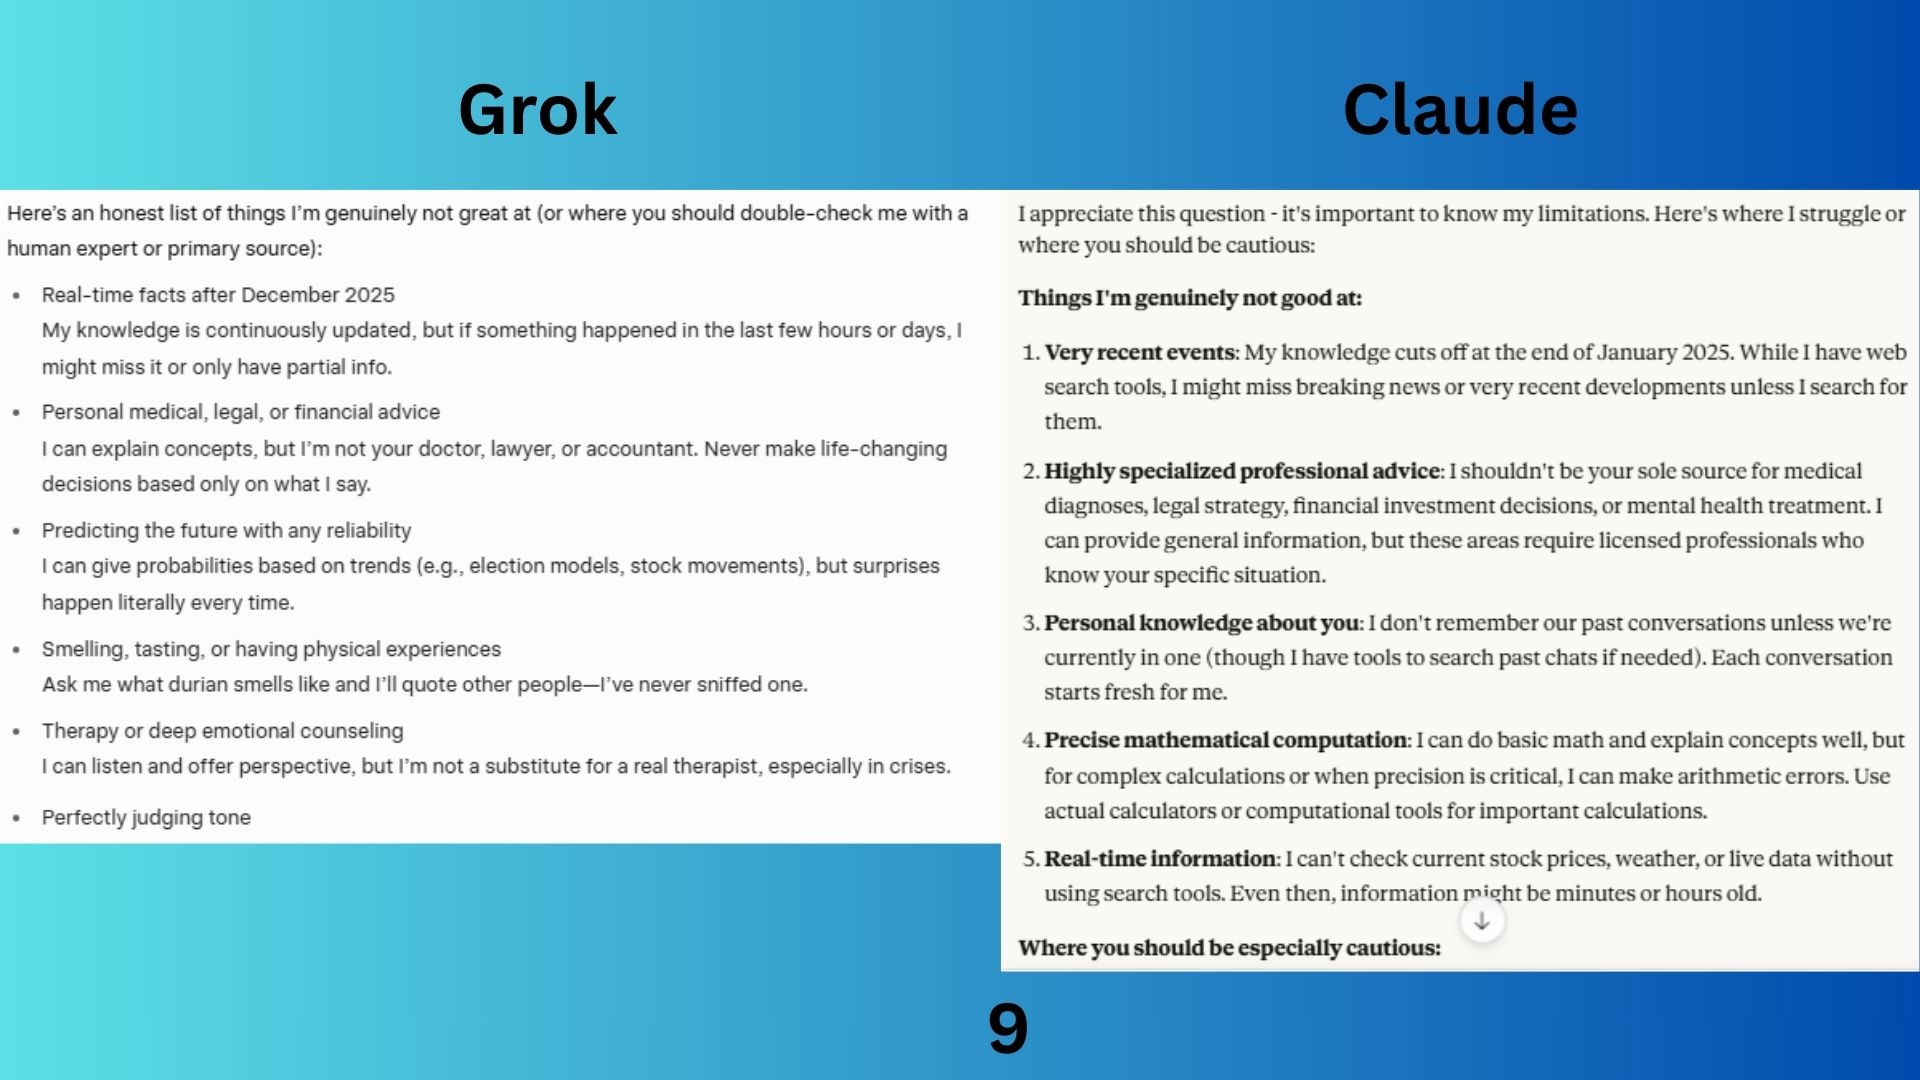
La pregunta es: ¿Cuáles son tus debilidades? ¿Y qué tipo de preguntas no se deberían esperar de ti para que las respondas?
Grok 4.1 era sencillo y claro, pero menos detallado y analítico.
Soneto de Claudio 4.5
Creó una lista de sus debilidades y luego explicó su naturaleza proporcionando un marco claro para las situaciones que requieren precaución.
Ganador: Claude gana gracias a un análisis más completo, estructurado y cuidadosamente organizado de sus limitaciones.
Ganador general: Claude Sonnet 4.5
Si bien Grok 4.1 a veces destacaba por su audaz creatividad y una estructura pragmática (especialmente en consejos emocionales o prácticos), Claude ofrecía constantemente respuestas más reflexivas, informadas y educativas. Ganó en razonamiento, profundidad técnica, distinciones éticas y responsabilidad moral, áreas cruciales para la confianza, la inteligencia y la utilidad a largo plazo.
Si buscas una IA que piense rápido y te sorprenda con frecuencia, Grok tiene sus momentos. Pero si buscas una que piense profundamente, explique con claridad y te guíe con un contexto fiable, Claude Sonnet 4.5 es la mejor opción.

Los comentarios están cerrados.